

Context layer : donner du sens aux données d’une CDP agentique
6min • Édité le 22 oct. 2026

Alexandra Augusti
Chief of Staff
Votre agent IA a accès à vos commandes, votre CRM et vos campagnes. Vous lui demandez de préparer une audience de clients à forte valeur. Il additionne les achats, mais inclut les commandes annulées et ignore les remboursements. Son calcul est cohérent avec les tables consultées. Il ne correspond pourtant pas à votre définition métier...
👉 C'est là le rôle d'un context layer.
Un context layer, ou couche de contexte, rend ces définitions accessibles aux agents, avec les informations nécessaires pour les appliquer. Dans une CDP agentique, il aide à relier les données clients, les objectifs marketing et les conditions d’utilisation des applications.
À retenir
Le context layer associe les données à leur sens métier, leur provenance et leurs conditions d’utilisation.
Il peut s’appuyer sur une couche sémantique, des mécanismes de sélection et des interfaces comme des MCP.
Le contexte doit être sélectionné pour la tâche, actualisé et vérifiable.
Les permissions et les règles d’exécution doivent aussi être appliquées par les systèmes qui réalisent l’action.
Qu’est-ce qu’un context layer pour les agents IA ?
Un context layer est un ensemble organisé de connaissances et de mécanismes qui fournit à un agent les connaissances utiles pour interpréter des données et réaliser une tâche. Il peut réunir définitions métier, relations entre objets, documentation, état actuel du client et règles opérationnelles.
Le terme désigne une fonction d’architecture dont le périmètre varie selon les solutions. Il n’implique ni une base de données particulière, ni l’achat d’un outil supplémentaire. Une partie de ces connaissances peut déjà exister dans vos modèles de données, votre catalogue ou votre CDP.
Un context layer doit notamment contenir les définitions sémantiques, la traçabilité, les responsabilités et les politiques d’accès. Pour une équipe marketing, la question pratique est la suivante : l’agent retrouve-t-il la bonne définition, sur les bonnes données, pour l’opération demandée ?
La couche de contexte ne se confond pas avec la fenêtre de contexte du modèle. Elle contient les informations effectivement transmises au LLM pendant un traitement. Le context layer organise les ressources à partir desquelles ces informations peuvent être sélectionnées.
Pourquoi l’accès aux données clients ne suffit-il pas ?
Une table indique qu’un client a passé une commande. Elle ne précise pas toujours si cette commande compte dans le chiffre d’affaires retenu par le marketing. Son statut, un retour ultérieur ou le rattachement à un autre compte peuvent changer l’interprétation.
Trois écarts apparaissent souvent entre les données disponibles et une décision exploitable.
Le sens des indicateurs. Un client actif peut être un acheteur récent, un abonné disposant d’un contrat ou un utilisateur connecté. Demander à l’agent de « cibler les clients actifs » sans choisir une définition laisse un choix commercial implicite.
L’état de la situation. Une personne pouvait être éligible hier et avoir racheté aujourd’hui. L’historique reste utile pour l’analyse, mais l’activation doit intégrer les changements pertinents.
Le cadre de l’action. Être intéressant commercialement ne suffit pas pour entrer dans une campagne. Il faut aussi connaître les exclusions, la pression marketing et les conditions d’utilisation du canal envisagé.
Un prompt détaillé peut aider lors d’un essai. Si chaque service recopie ses règles dans ses conversations, les versions risquent toutefois de diverger. Ce socle sert à rendre ces connaissances réutilisables, avec un responsable et une source identifiables.
Quelles informations faut-il réunir ?
Les définitions métier et leurs relations avec les données
Documentez les concepts qui changent réellement une sélection : achat éligible, revenu net, client fidèle, risque de churn ou valeur client. Chaque définition doit renvoyer aux champs, filtres et périodes nécessaires à son calcul.

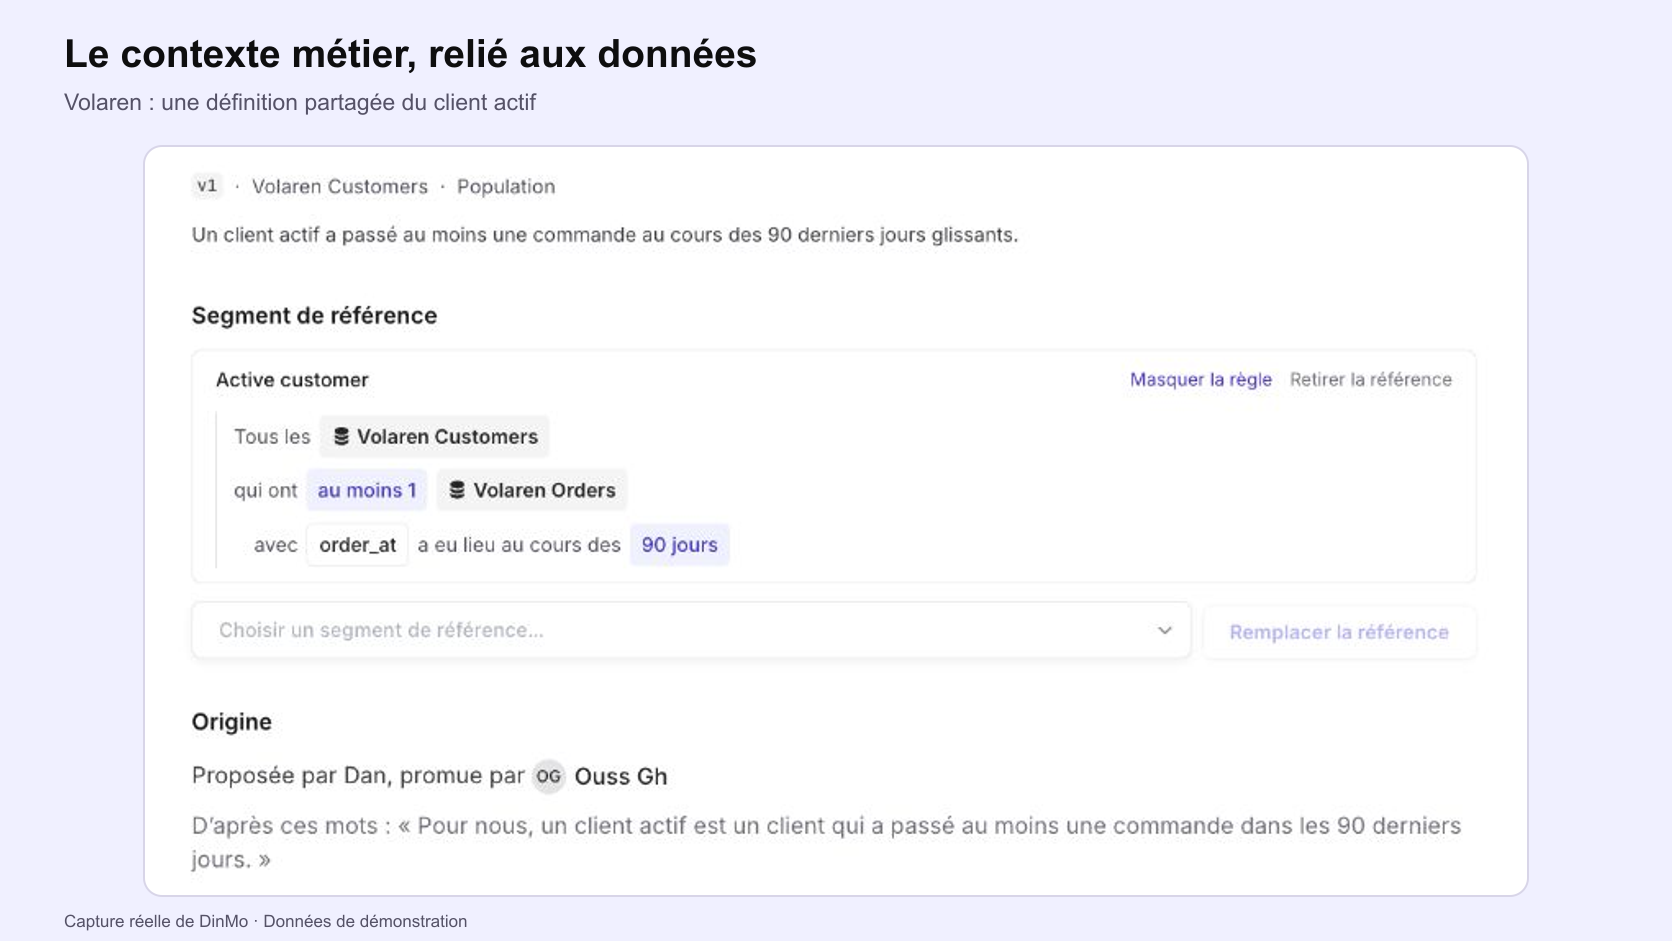
Une définition partagée, associée à une règle de sélection vérifiable.
Par exemple, « valeur sur douze mois » doit préciser le traitement des retours, la devise et le périmètre des achats. Une estimation de valeur future doit rester identifiable comme une prédiction, avec sa date de calcul et son horizon.
L’identité, les relations et l’état du client
L’agent doit comprendre les objets manipulés : personne, compte, foyer, commande, abonnement ou produit. Un contact peut appartenir à un compte B2B comprenant plusieurs utilisateurs. Une action décidée au niveau du compte ne se transpose pas automatiquement à chaque personne.
Ajoutez les signaux utiles au cas d’usage : dernier achat, statut d’abonnement, interactions récentes, préférences et incidents ouverts. Les règles de rapprochement d’identité doivent être explicites, sans demander au modèle de deviner que deux profils représentent le même client.

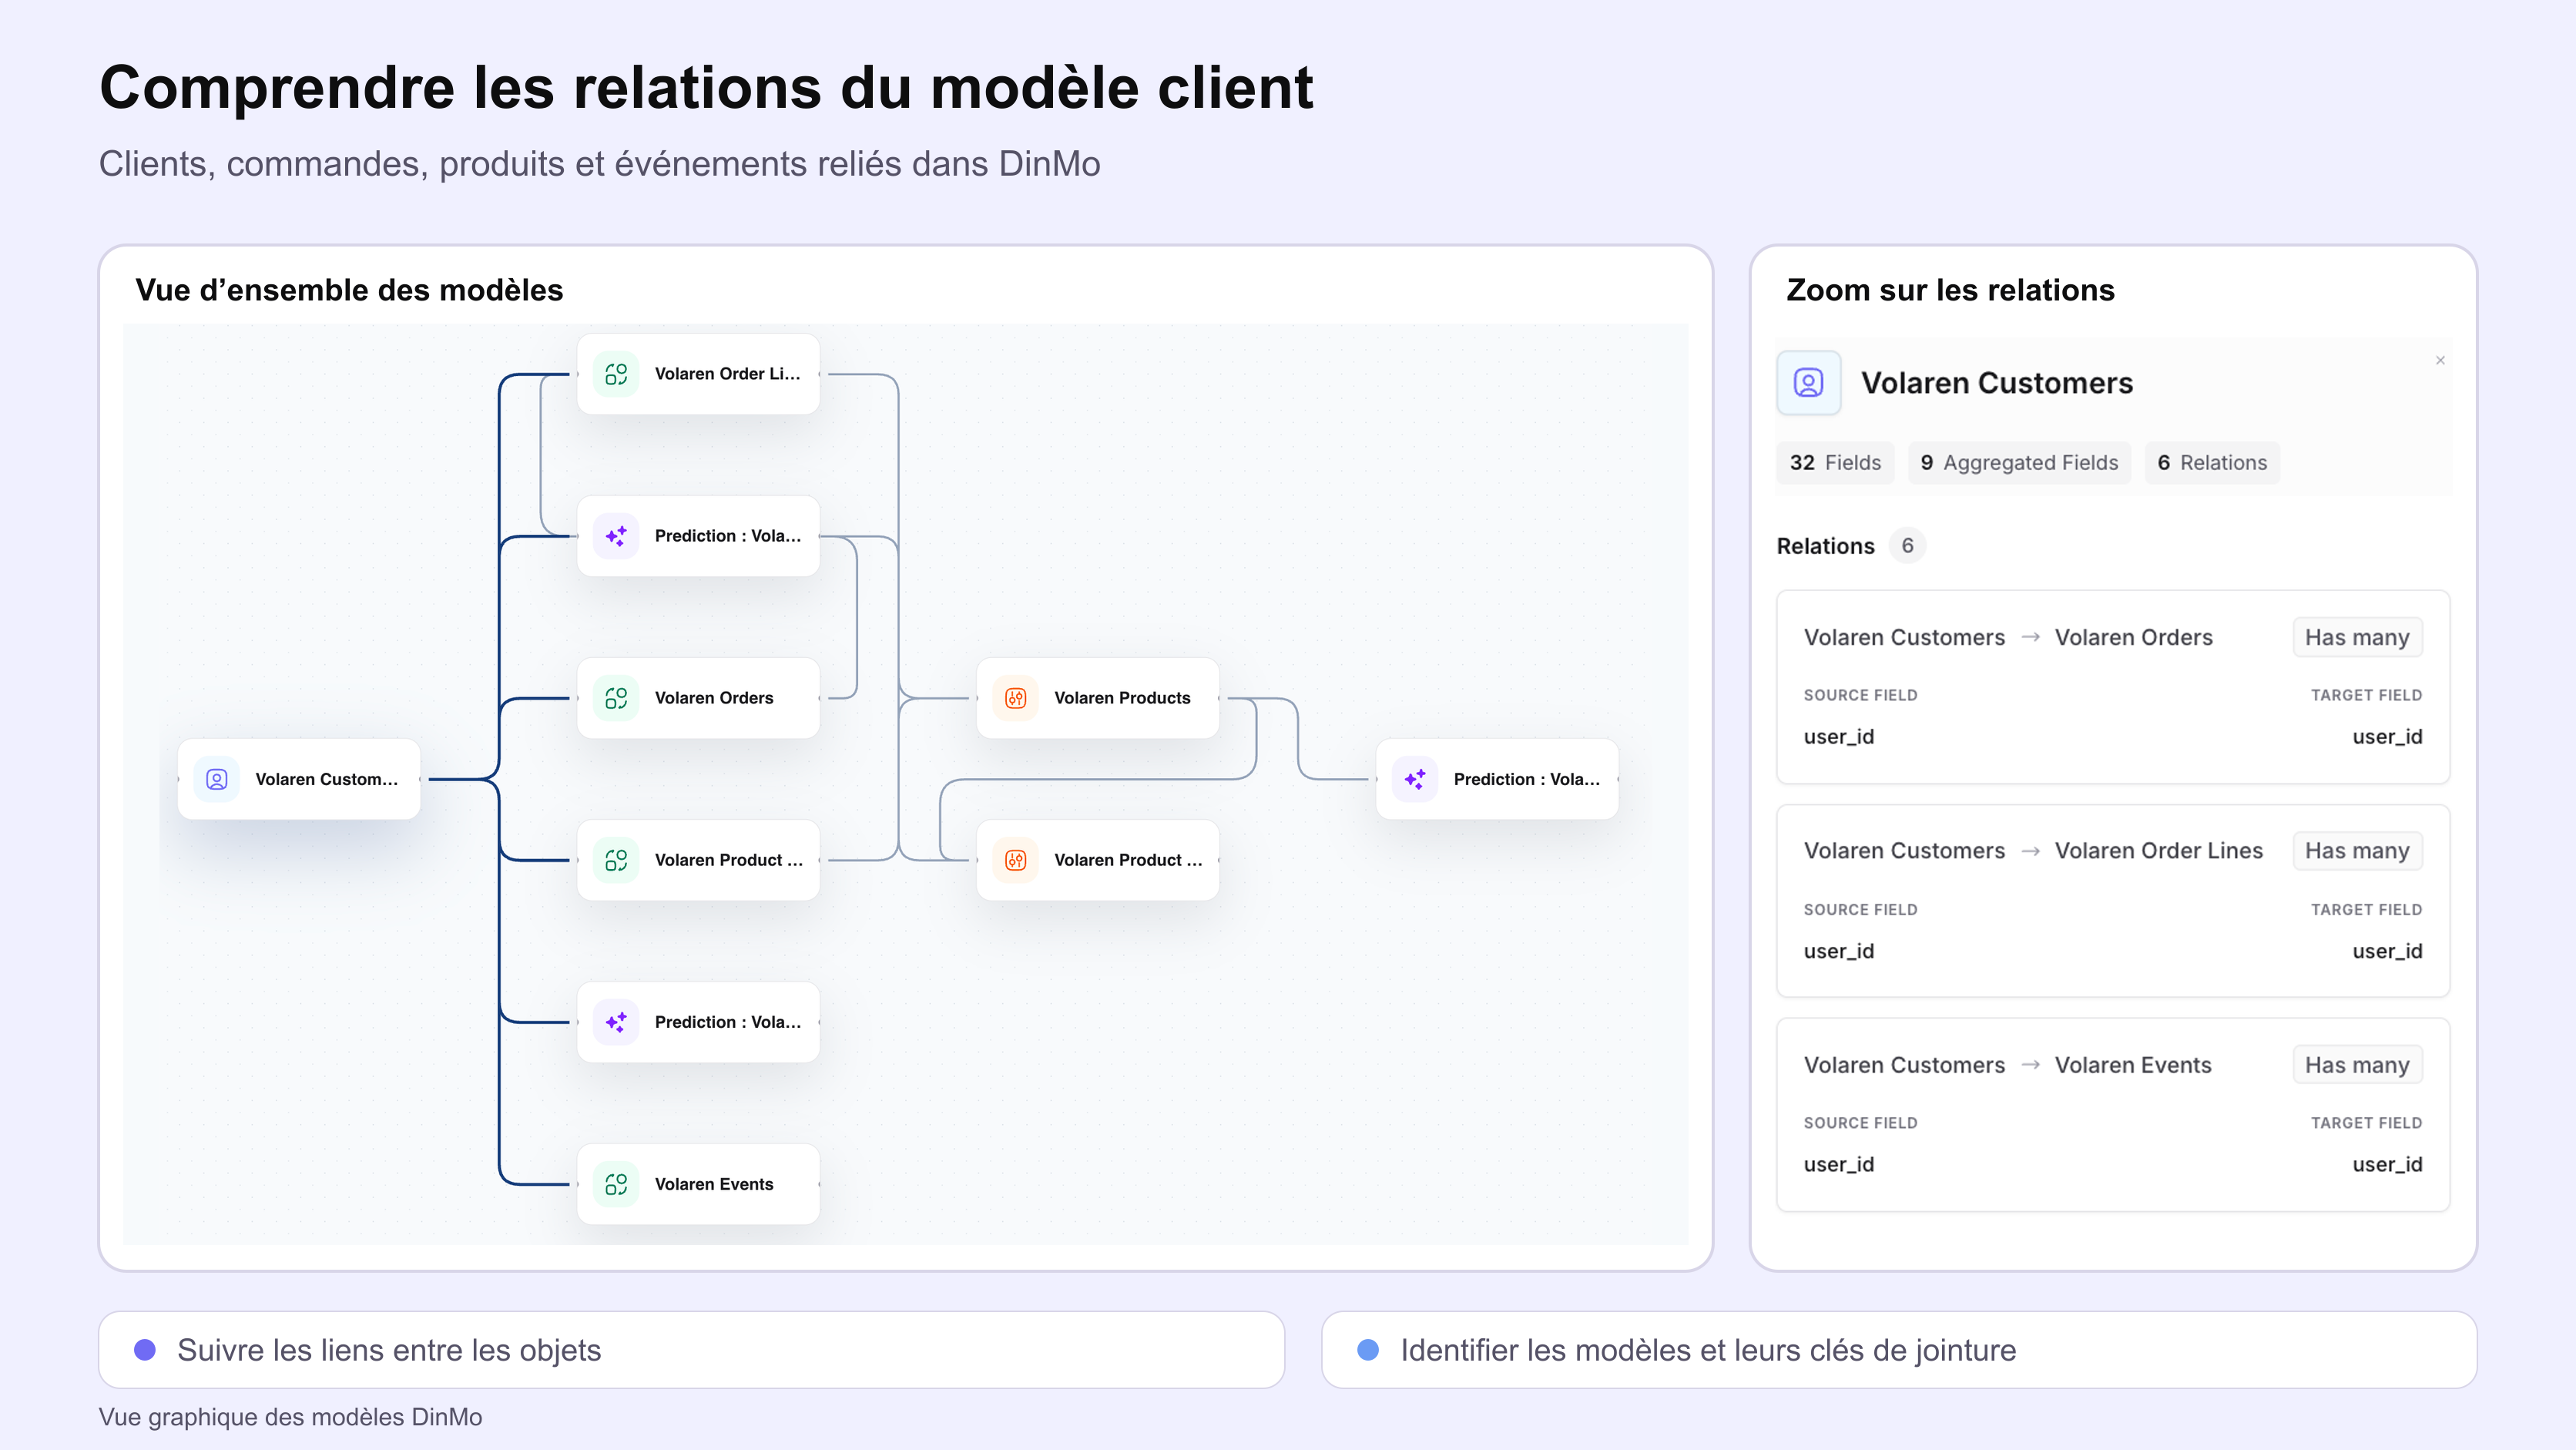
La vue graphique DinMo montre les liens entre le modèle client, les commandes, les produits et les événements.
Les objectifs et les règles opérationnelles
Précisez ce que l’équipe cherche à améliorer, les actions possibles et les contraintes. Une réactivation peut privilégier la marge, limiter les remises ou laisser certains clients au suivi d’un conseiller.
Distinguez une préférence, que le système peut prendre en compte dans une recommandation, d’une interdiction, que l’outil d’exécution doit faire respecter. Une mention dans un document ne remplace pas un contrôle de permission.
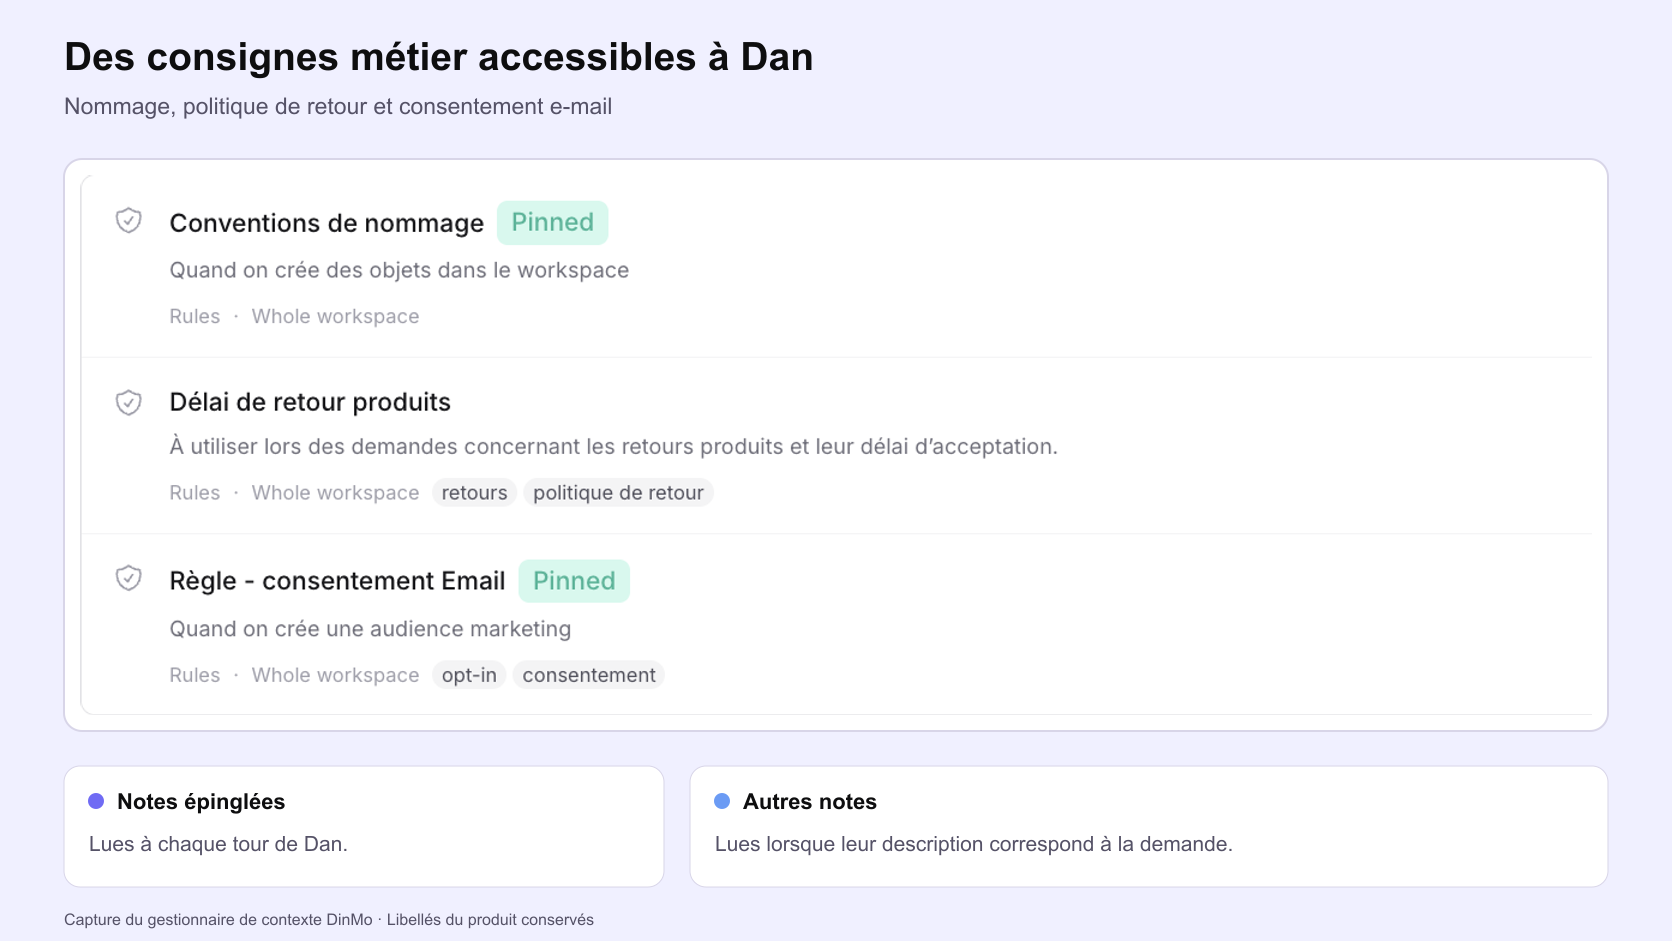
Les notes partagées donnent à Dan les consignes utiles à chaque demande.
La provenance, la fraîcheur et la validité
Pour chaque information déterminante, conservez sa source, son propriétaire, sa date de mise à jour et ses éventuelles limites. Un score recalculé chaque semaine et un événement de commande récent n’ont pas la même durée de validité.
En cas de définitions contradictoires, une priorité doit être définie. Si la source de référence est indisponible ou trop ancienne pour l’action envisagée, l’agent doit signaler cette limite plutôt que compléter l’information par une supposition.
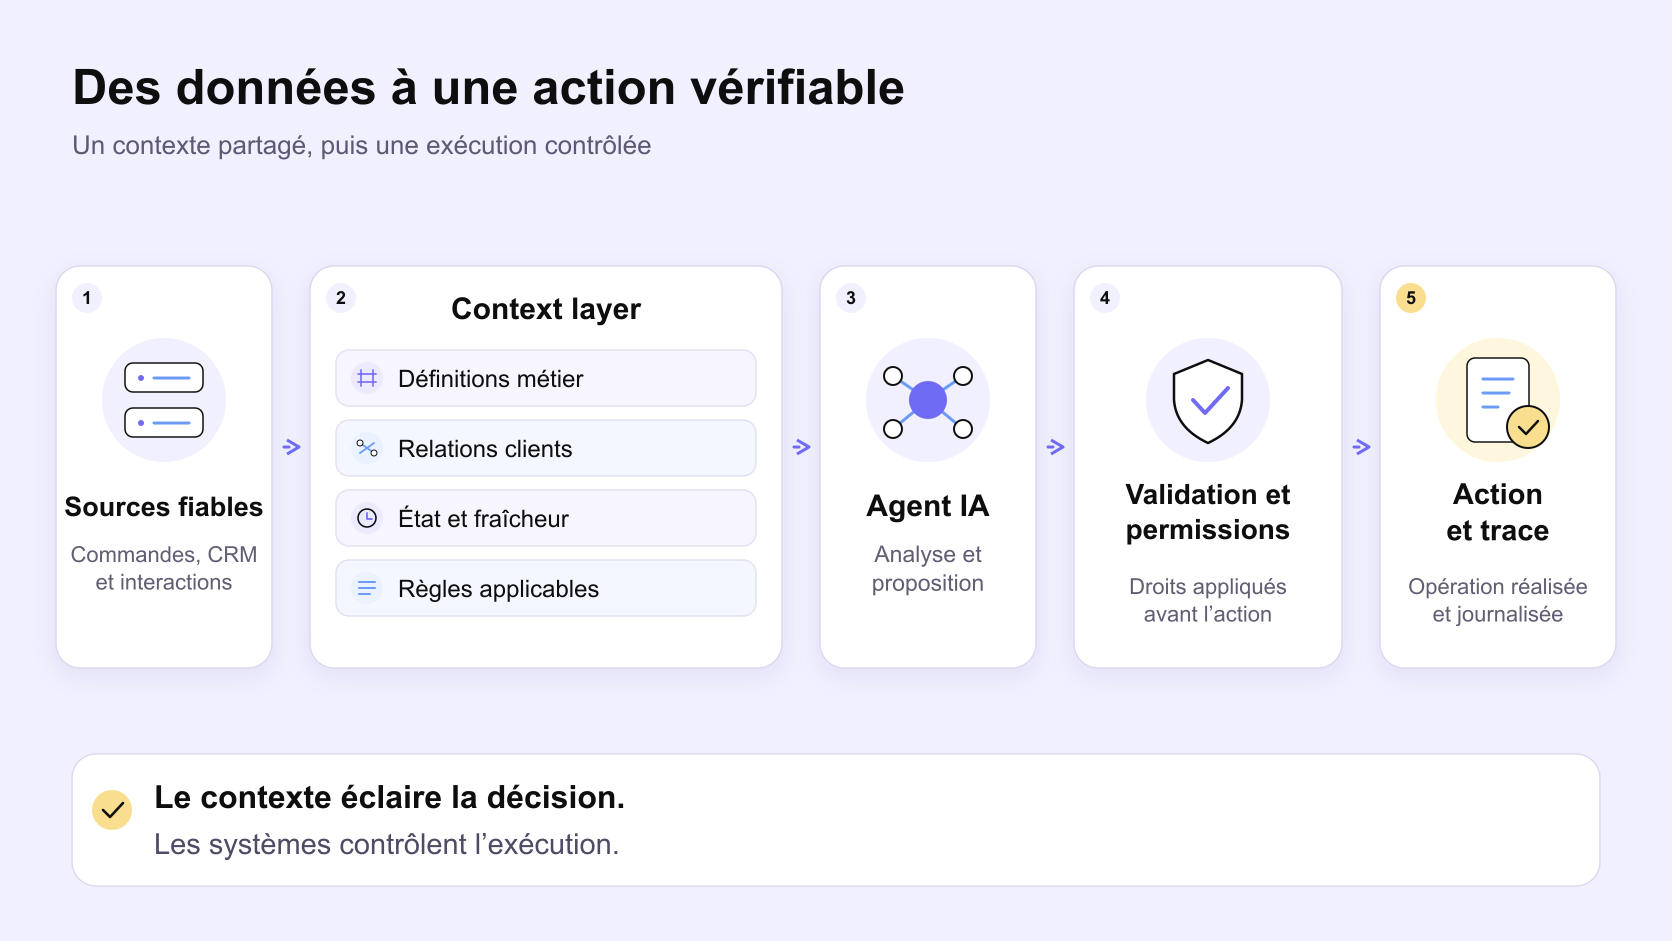
Les connaissances partagées guident la proposition, puis les permissions sont vérifiées avant l’action.
Context layer, semantic layer, RAG, MCP : quelles différences ?
Ces notions répondent à des besoins complémentaires. Elles ne constituent pas nécessairement des briques séparées à déployer.
Notion | Rôle | Exemple dans une CDP |
|---|---|---|
Context layer | Organiser et fournir le contexte utile à une tâche | Associer définition du client fidèle, état récent et exclusions |
Semantic layer | Partager des définitions de métriques, dimensions et relations | Calculer le revenu net avec la définition validée |
RAG | Rechercher des informations et les fournir au modèle pour sa réponse | Retrouver une règle dans les consignes de campagne |
MCP | Standardiser les échanges entre applications IA et systèmes externes | Exposer une fonction de recherche ou un outil d’analyse |
Context graph | Représenter des relations contextuelles sous forme de graphe, selon l’implémentation | Relier client, compte, interactions et décisions documentées |
Context engineering | Concevoir la sélection et la gestion du contexte transmis au modèle | Choisir les informations utiles à chaque étape de l’agent |
La couche sémantique peut déjà servir des agents IA, par exemple avec des métriques partagées accessibles aux outils. Elle peut donc contribuer à ce socle ; la distinction dépend des fonctions réellement couvertes.
Le RAG peut retrouver du texte ou d’autres informations pertinentes. Il ne garantit pas, à lui seul, qu’une règle est encore valide ou qu’une action est autorisée. De même, un MCP facilite la connexion aux outils : le protocole ne crée pas les définitions métier et ne remplace pas leur gouvernance.
Enfin, un graphe peut faciliter l’exploration des relations sans être obligatoire pour démarrer. La priorité consiste à rendre les connaissances utiles accessibles et contrôlables, quel que soit leur stockage.
Graphes de connaissances et mémoire : où les placer ?
Relier les objets avec un graphe de connaissances
Un graphe de connaissances représente des entités et leurs relations : un client passe une commande contenant un produit. Une ontologie précise les types d’objets et leurs liens autorisés. Cette représentation peut également relier un indicateur à sa définition et à son responsable.
Un context graph peut s’appuyer sur ce principe et, selon les solutions, conserver des décisions. Vérifiez ce qui est effectivement enregistré : le nom ne garantit ni le contenu ni sa fiabilité.
Retrouver un document avec la recherche vectorielle
La recherche vectorielle rapproche des éléments selon leur similarité sémantique. Le parcours d’un graphe suit des relations explicites.
Un document ressemblant à la demande peut être périmé. Vérifiez sa version et son périmètre. Le calcul d’un revenu exige, lui, des transactions structurées et la bonne définition.
Séparer la mémoire de session des connaissances partagées
La mémoire de session retient l’objectif, les filtres et les résultats intermédiaires. Une mémoire persistante conserve des informations entre conversations.
Une correction locale ne doit pas automatiquement modifier une règle commune. Prévoyez validation, responsable, date d’effet et expiration des informations mémorisées.
Comment le contexte accompagne-t-il une décision marketing ?
Prenons un exemple fictif : une enseigne souhaite préparer une réactivation de clients à forte valeur, sans accorder de remise systématique. Les seuils suivants illustrent son propre cadre métier.
Préciser la demande. L’équipe retient les clients ayant généré plus de 500 € de revenu net sur douze mois, sans achat éligible depuis 90 jours. Elle fixe la date de référence et les statuts de commande retenus.
Retrouver les bonnes connaissances. L’agent consulte la définition du revenu net, le modèle client de référence et les exclusions. Il peut identifier une règle de suspension lorsqu’un dossier de service client est ouvert.
Calculer et expliquer. Les outils autorisés produisent l’audience. Le résultat présente les critères, les volumes avant et après exclusions, la période et les sources. Une ligne de profil doit pouvoir être rapprochée des faits qui justifient sa sélection.
Cette étape relève de l’agentic analytics lorsqu’un agent organise plusieurs vérifications pour répondre à la question métier.
Vérifier avant activation. Un nouveau contrôle tient compte des achats récents, de l’éligibilité au canal et des contacts déjà effectués. L’enseigne exclut ici les clients sollicités dans les sept derniers jours. Les permissions et validations s’appliquent dans les outils concernés.
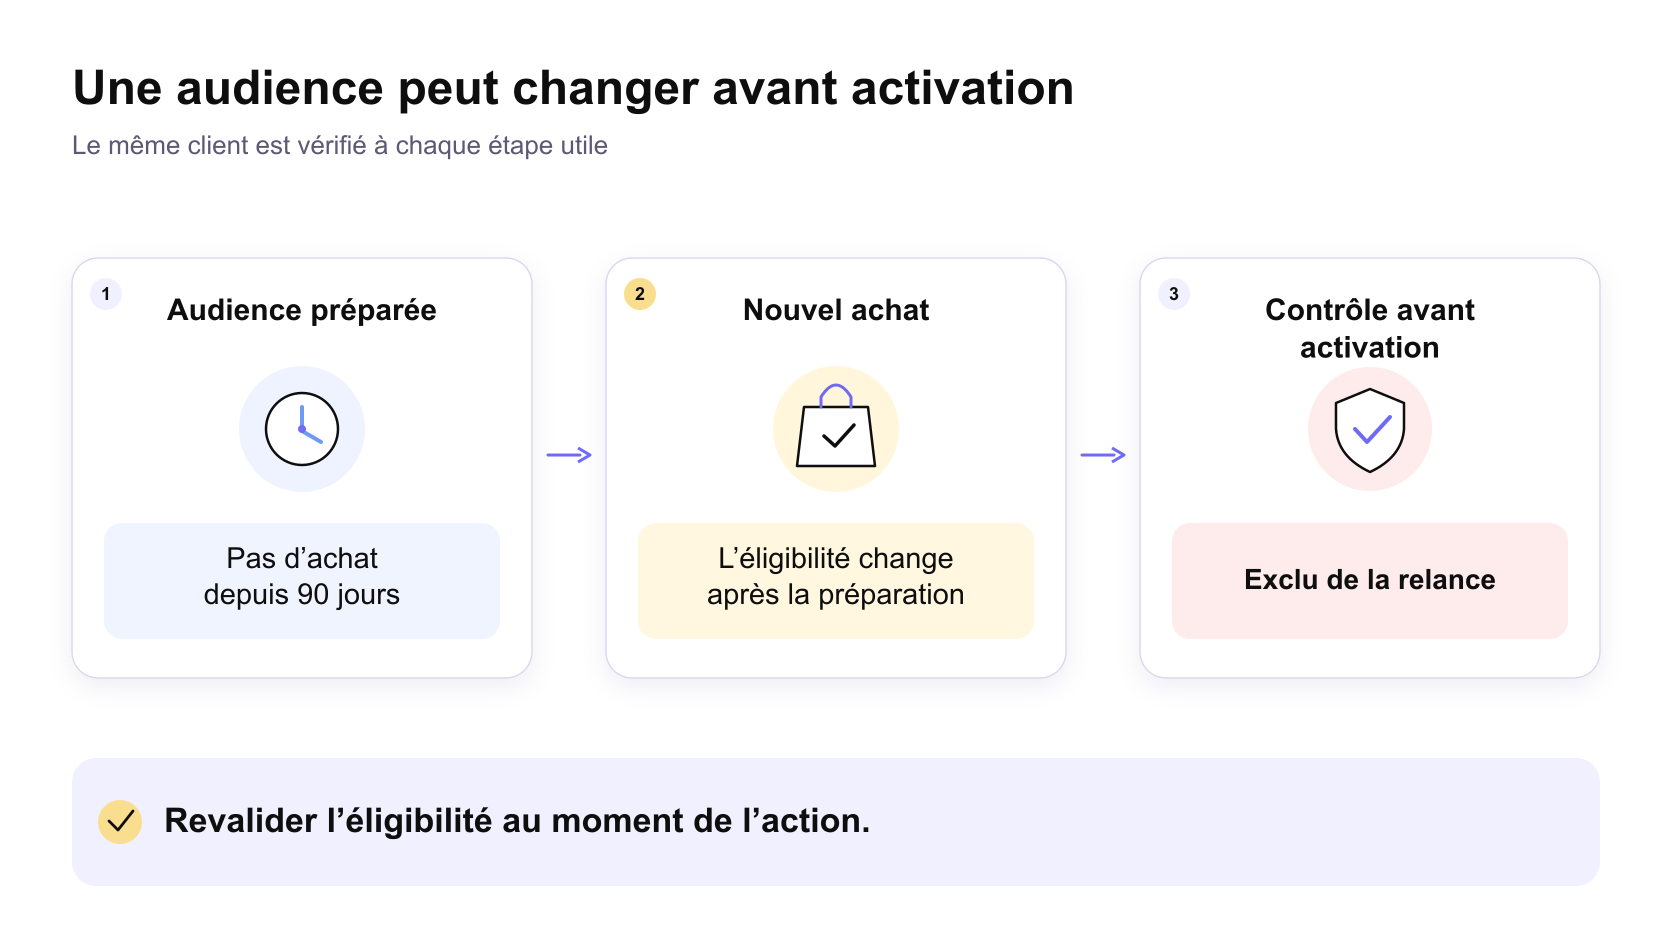
Un nouvel achat change l’éligibilité à la relance.
Conserver la trace. L’équipe enregistre la version des critères approuvés, la date de préparation et le résultat d’exécution. Elle peut ensuite rapprocher l’action des résultats observés, sans attribuer automatiquement chaque vente à la campagne.
Ces ressources fournissent les éléments de décision ; les applications réalisent les calculs et les opérations autorisées. Cette répartition permet de vérifier ce qui a été proposé et ce qui a effectivement eu lieu.
Comment construire cette couche de contexte ?
Commencez par un cas d’usage limité. Il est plus utile de fiabiliser une audience de réactivation que de documenter toutes les connaissances de l’entreprise avant le premier essai.
Recensez l’existant. Identifiez les modèles, définitions, documents et contrôles déjà disponibles. Réutilisez les sources de référence.
Attribuez les responsabilités. Le marketing valide le sens des critères ; l’équipe data vérifie leur traduction et leurs sources ; les responsables des outils contrôlent les permissions.
Organisez l’accès au contexte. Selon l’architecture, il peut passer par des métadonnées, des requêtes, une recherche documentaire ou des API. Limitez les informations transmises au modèle à ce qui est utile pour la tâche.
Versionnez et actualisez. Une modification du calcul de valeur client doit pouvoir être identifiée. Le contexte vivant, parfois appelé living context layer, suppose une maintenance organisée, pas une mémoire qui se corrigerait seule.
Testez avant d’étendre. Comparez les résultats à une référence revue par l’équipe et vérifiez les situations ambiguës.
Le context engineering décrit par Anthropic porte précisément sur la sélection et la gestion des informations utiles au modèle. Donner accès à davantage de données n’est pas un objectif en soi.
De la question à une réponse vérifiable en production
Le parcours commence par la question et les droits de l’utilisateur. Les ressources sélectionnées apportent définitions, règles et état opérationnel. La traçabilité relie un indicateur à ses sources : une absence de retours dans les transactions peut expliquer une variation sans changement de comportement client.
Les applications vérifient les permissions avant exécution. La restitution conserve critères, période, sources et limites, sans exposer tous les dossiers clients ou documents disponibles.
Appliquer ces principes à d’autres décisions clients
Un renouvellement B2B nécessite les relations entre compte et contacts, le contrat actuel et les éventuelles escalades au support. Pour une vente croisée, il faut relier produits, achats et critères d’éligibilité, en tenant compte des retours. Dans les deux cas, les connaissances éclairent la proposition et un processus autorisé encadre son exécution.
Comment vérifier que cette couche fonctionne ?
Préparez quelques cas dont la réponse attendue est connue : commande remboursée, profil en double, règle contradictoire, source périmée ou client devenu inéligible après la préparation de l’audience.
Vérifiez si le système applique la bonne définition, cite la source et signale ce qu’il ne sait pas. Lorsqu’une contrainte manque, l’arrêt ou la demande de clarification peut être le résultat attendu.
Suivez des indicateurs adaptés : accord avec l’audience de référence, exclusions manquées, corrections humaines, temps de revue et ancienneté des données utilisées. Le taux d’erreur doit préciser sa méthode de calcul et le jeu de cas testé.
Un contexte plus complet peut améliorer la pertinence du travail.
⚠️ Il ne garantit ni l’absence d’erreurs du modèle ni un gain marketing. Les droits d’accès, les contrôles d’exécution et l’évaluation restent nécessaires.
Avec Dan, vos définitions métier prennent vie
Un client « actif », une audience « VIP », une règle de campagne : ces termes ont un sens précis chez vous. Dan, l’analyste IA de DinMo, s’appuie sur ce langage métier pour préparer des analyses et des audiences adaptées à votre demande.
Le Context Manager réunit vos définitions partagées et vos notes métier. Une définition peut être reliée à un segment de référence ; les consignes utiles peuvent être épinglées ou retrouvées selon la demande. Votre équipe rend ainsi son expertise réutilisable dans les échanges avec Dan.
Demandez-lui, par exemple : « Prépare une audience e-mail de clients actifs. » Dan retrouve la définition retenue et consulte les notes pertinentes. Lorsqu’une référence existe et lui est accessible, il s’appuie sur la règle du segment associé. Les outils de requête calculent les résultats sur les données actuelles. Vous pouvez consulter les définitions appliquées et les notes lues dans la conversation pour vérifier les bases de sa proposition.
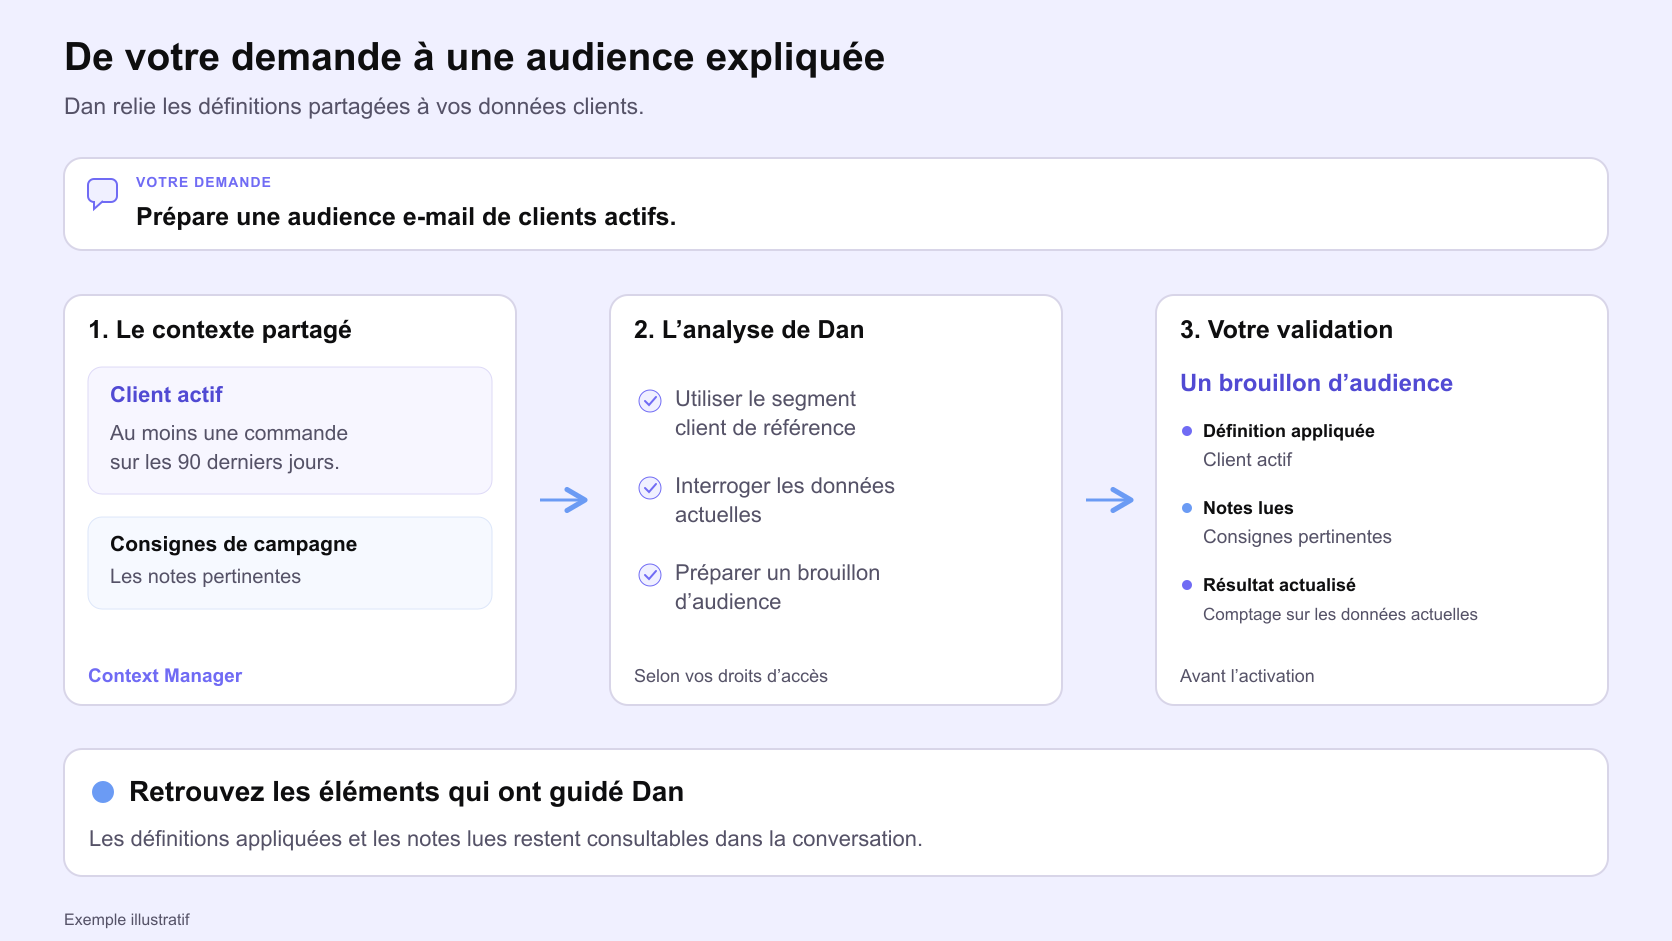
Dan relie une définition partagée et les consignes pertinentes à un brouillon d’audience dont vous pouvez examiner les bases.
Vous précisez un nouveau terme au cours de l’échange ? Dan peut vous proposer d’en faire une définition partagée, soumise à votre validation. Vos équipes gardent la main sur le sens métier et la revue des audiences.
Un contexte partagé pour des actions vérifiables
Une référence partagée rend les données interprétables dans un cadre métier. Sa valeur tient à la capacité de retrouver une définition fiable, de l’appliquer à une situation actuelle et d’en conserver la trace.